Базовых классов
Целевые акустические события и фон


ИНДОР / АКУСТИЧЕСКИЙ ИНТЕЛЛЕКТ
Лай, разбитое стекло или шумная компания. Разработали модель и встроенное ПО, которые превращают звук в понятное событие прямо на устройстве.
Концептуальная иллюстрация обработки звука
01 / КОНТЕКСТ
«Индор» создаёт систему мониторинга эксплуатации недвижимости. Владельцу или управляющему важно понимать, что происходит в помещении: например, шумит компания, лает собака или разбилось стекло.
Обычный порог громкости не объясняет причину шума. Телевизор, разговор и плач могут давать похожий уровень сигнала. Задача нашего проекта: добавить устройству распознавание звуковых событий и связать модель с логикой прошивки.
При этом анализ должен происходить на самом устройстве. Отправлять непрерывный аудиопоток на внешний сервер для классификации не предполагалось. Значит, модель нужно было не только обучить, но и подготовить к жизни в ограниченной памяти микроконтроллера.
Для VIQQ это проект на стыке машинного обучения, обработки сигналов и разработки встроенного ПО. Результат здесь проверяется не красивым графиком на ноутбуке, а поведением реального устройства.
ПРОЕКТ В ЦИФРАХ
Числа описывают устройство решения: какие звуки различает модель и как её ответ превращается в событие.
Целевые акустические события и фон
Речь, медиа и сирены для отделения контекста
Классификация и подтверждение события
Квантованное представление для устройства
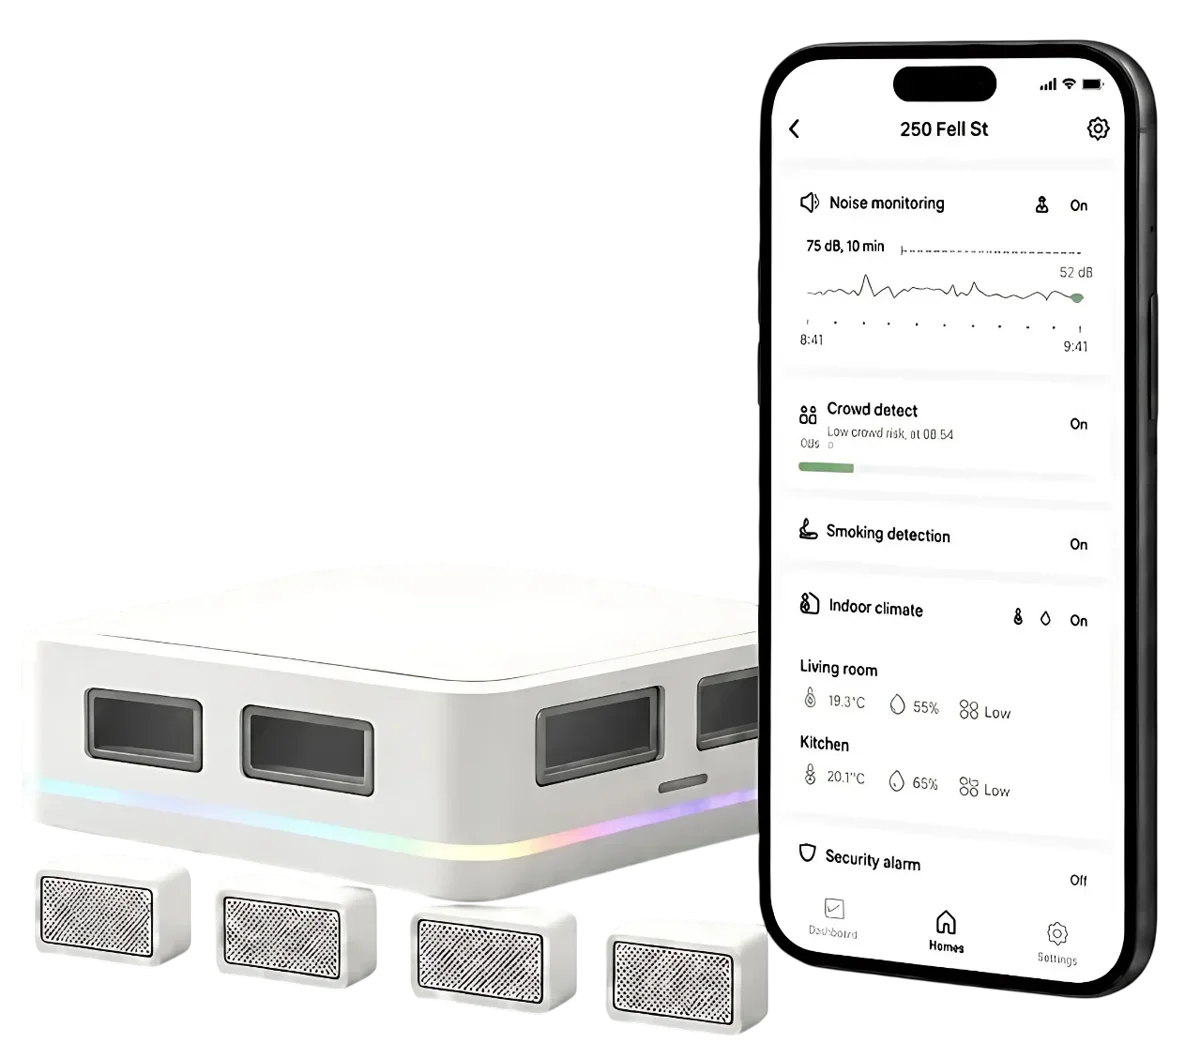
Визуализация платформы с сайта Индор
НАША ЧАСТЬ ПРОДУКТА
Мы работали над акустическим модулем: моделью классификации, её запуском на микроконтроллере и программной обработкой событий.
Корпус, другие датчики и приложение составляют более широкую платформу заказчика. Этот кейс посвящён именно ML и встроенному ПО.
ОТ ПОТРЕБНОСТИ К АЛГОРИТМУ
За одним показанием уровня шума могут стоять совершенно разные ситуации. Устройству нужен контекст, а человеку на другой стороне системы нужно осмысленное уведомление.
Важно отличить характерный звук от голоса, фоновой записи и других коротких сигналов. Один пик громкости этого не объясняет.
Короткое событие требует другого подхода, чем длительный шум. Случайный импульс или искажённый сигнал не должны автоматически считаться подтверждением.
Здесь важна последовательность окон и длительность ситуации. Решение нельзя строить на одном неуверенном предположении модели.
КЛЮЧЕВАЯ ИДЕЯ
Для человека звук существует во времени. Для модели мы превращаем его в набор признаков: выделяем окна и описываем распределение энергии по частотным полосам. Так у похожих на слух сигналов появляется структура, которую можно изучать и сравнивать.
02 / ИНЖЕНЕРНАЯ ЗАДАЧА
У микроконтроллера ограничены память и вычислительная мощность. Обученную сеть нужно адаптировать к устройству и оставить ресурсы для остальных задач прошивки.
Речь, музыка и похожие акустические паттерны мешают классификации. Важно проверять не только отдельное окно звука, но и последовательность результатов.
Команде заказчика нужны исходники, сборка и материалы по обучению, чтобы поддерживать решение и развивать его под собственные данные.
03 / КАК ЭТО РАБОТАЕТ
MEMS-микрофон передаёт цифровой аудиосигнал по I2S. На этом этапе важны входной уровень и отсутствие перегрузки: искажённый звук меняет признаки, которые получит модель.
Сигнал разбивается на окна, нормализуется и представляется через спектральные признаки. Так модель получает структуру, которую можно сравнивать с обучающими примерами.
Квантованная модель работает на микроконтроллере через TensorFlow Lite Micro. Её ответ относится к текущему окну и остаётся промежуточной оценкой, а не готовой тревогой.
Пороги и временные фильтры проверяют последовательность результатов. Только подтверждённое событие передаётся дальше через MQTT, отдельно от диагностических предположений модели.
Выберите этап, чтобы посмотреть его роль. Изображение иллюстрирует принцип, а не внешний вид оборудования.
В диагностическом логе могут появляться разные предположения модели. Событие формируется отдельным слоем логики, после проверки последовательности окон и условий срабатывания.
Схема упрощена для описания проекта. Классификация выполняется локально; для интеграции передаётся информация о событии.
ДАННЫЕ И ОБУЧЕНИЕ
Работу с моделью начали с целевых классов и подготовки аудиоматериалов. Для акустической классификации важны не только записи нужного звука, но и примеры того, что на него похоже. Иначе модели приходится выбирать целевой класс даже для сигнала, который к нему не относится.
В ходе проекта исходную классификацию расширили. К базовым классам добавились служебные категории для речи, медиа и сирен. Их задача в этой архитектуре: дать модели возможность отделять часть постороннего акустического контекста от событий, которые интересуют систему.
Затем модель адаптировали для запуска на устройстве. Квантование INT8 и TensorFlow Lite Micro позволили работать с компактным представлением сети, а настройки обработки входного сигнала пришлось согласовать с тем, как звук был представлен при обучении.
04 / ВНУТРИ МОДЕЛИ
Реальные графики из материалов проекта показывают представление аудио для шести базовых классов. Это примеры входных признаков, а не отчёт о точности распознавания.
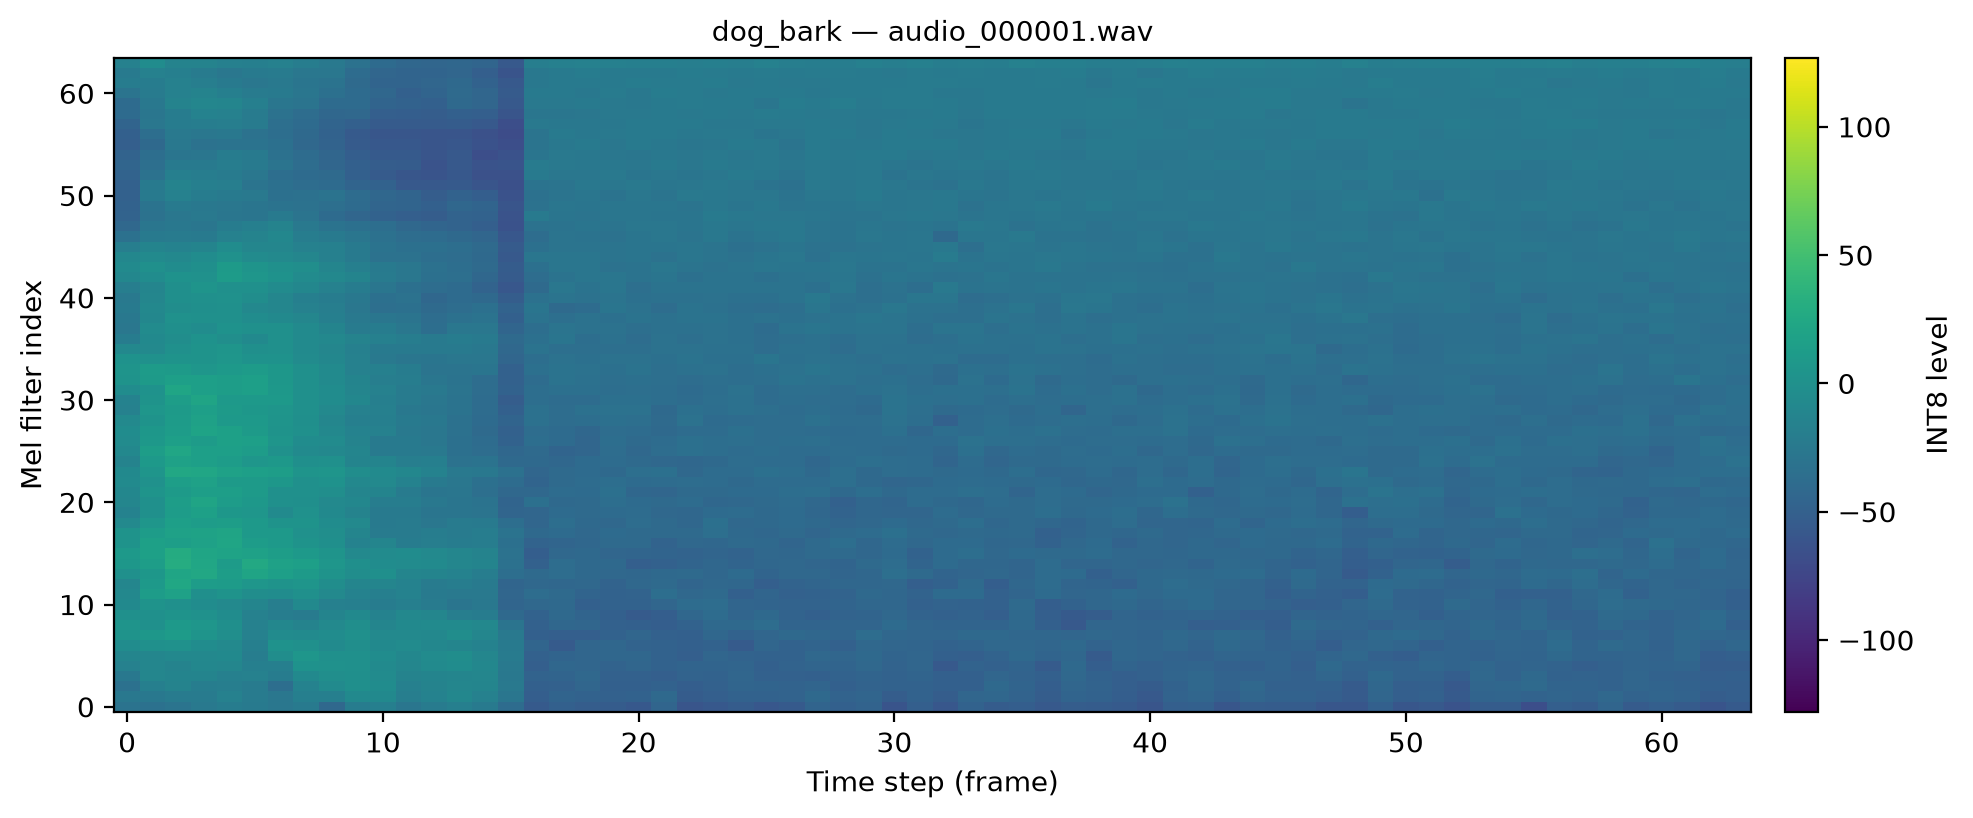
Лай собаки
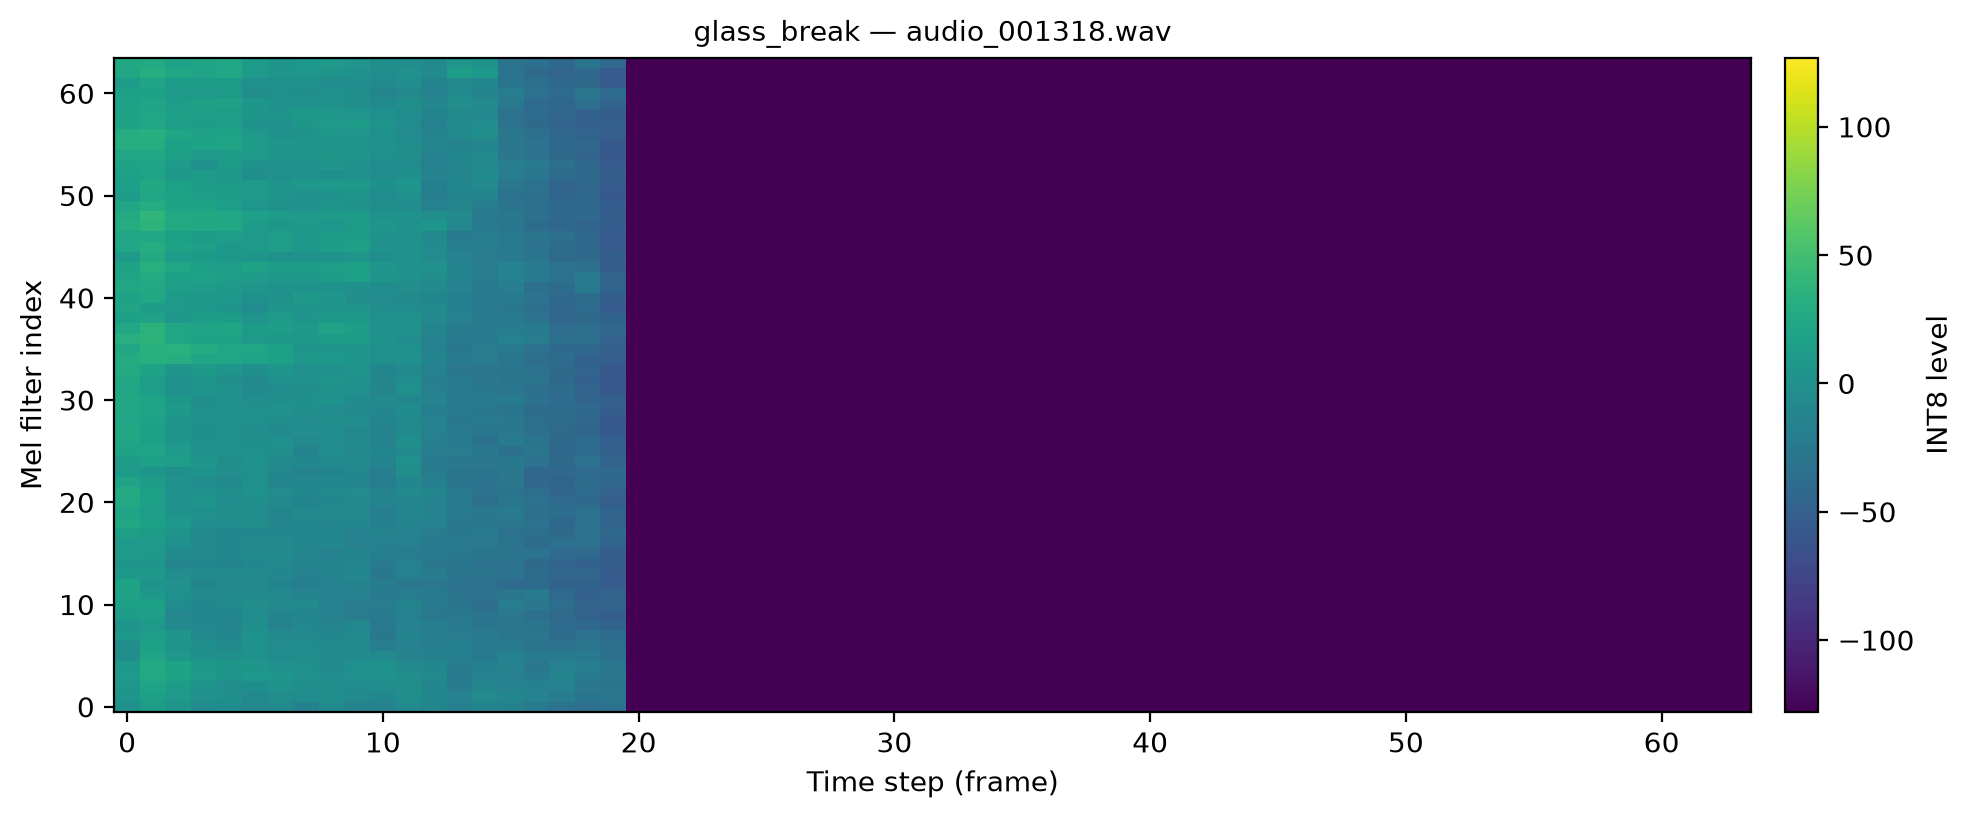
Разбитое стекло
Выберите два класса и сравните реальные примеры. Графики открываются в исходном размере.
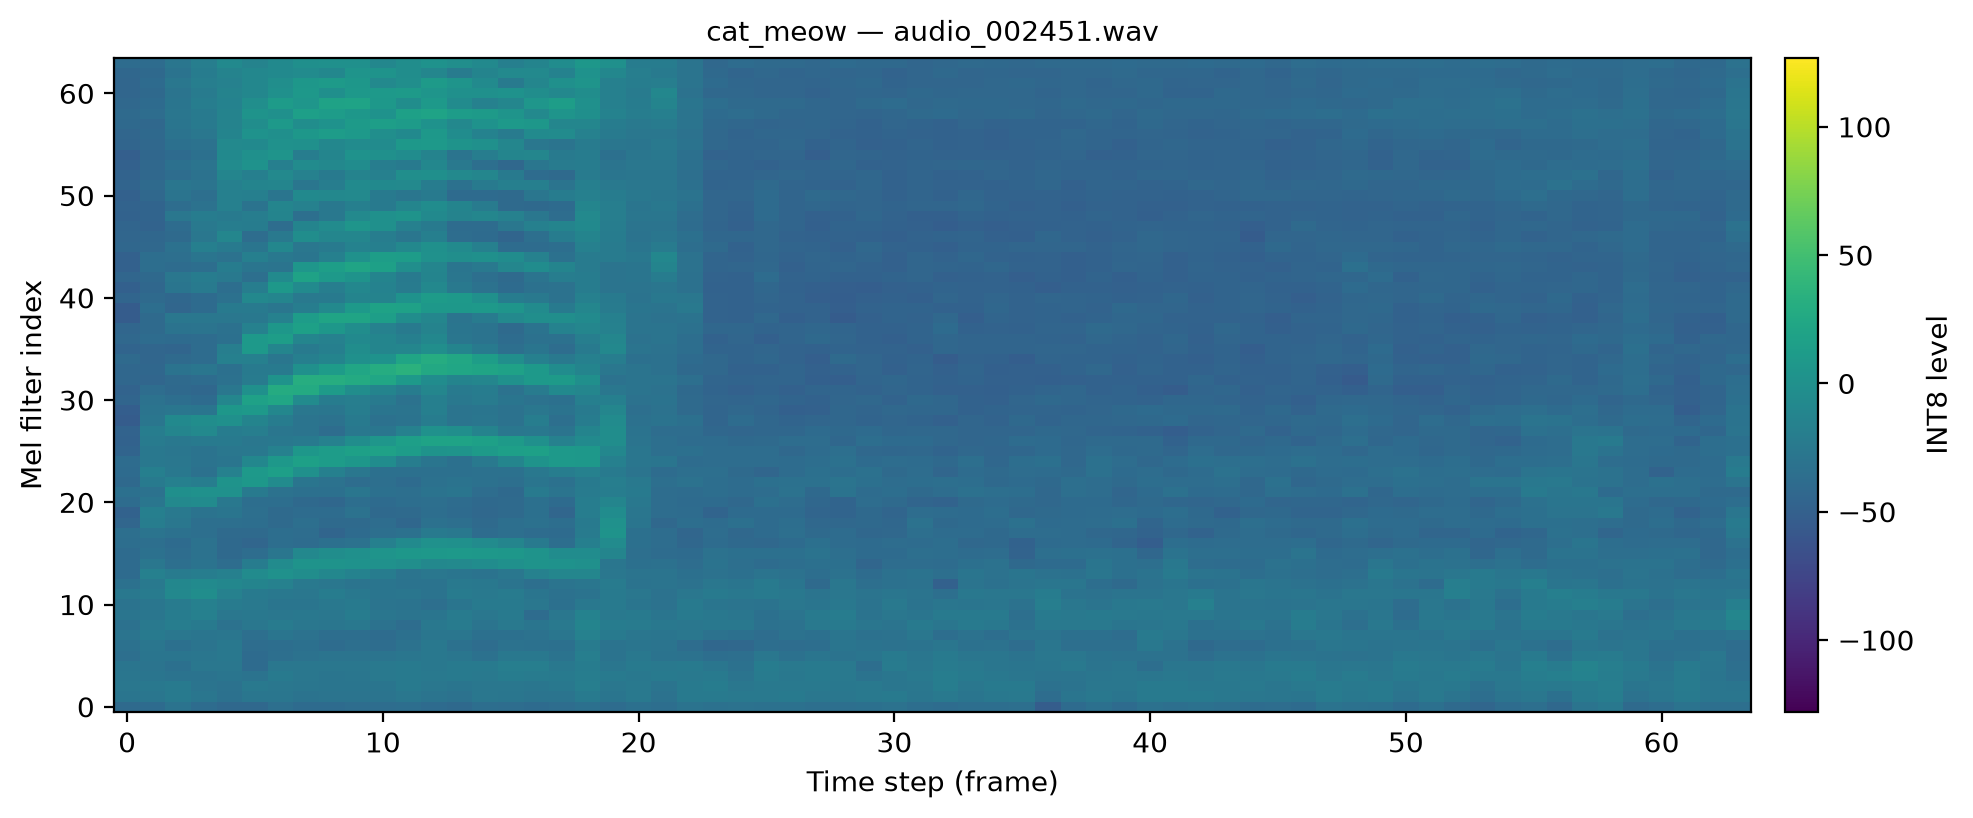
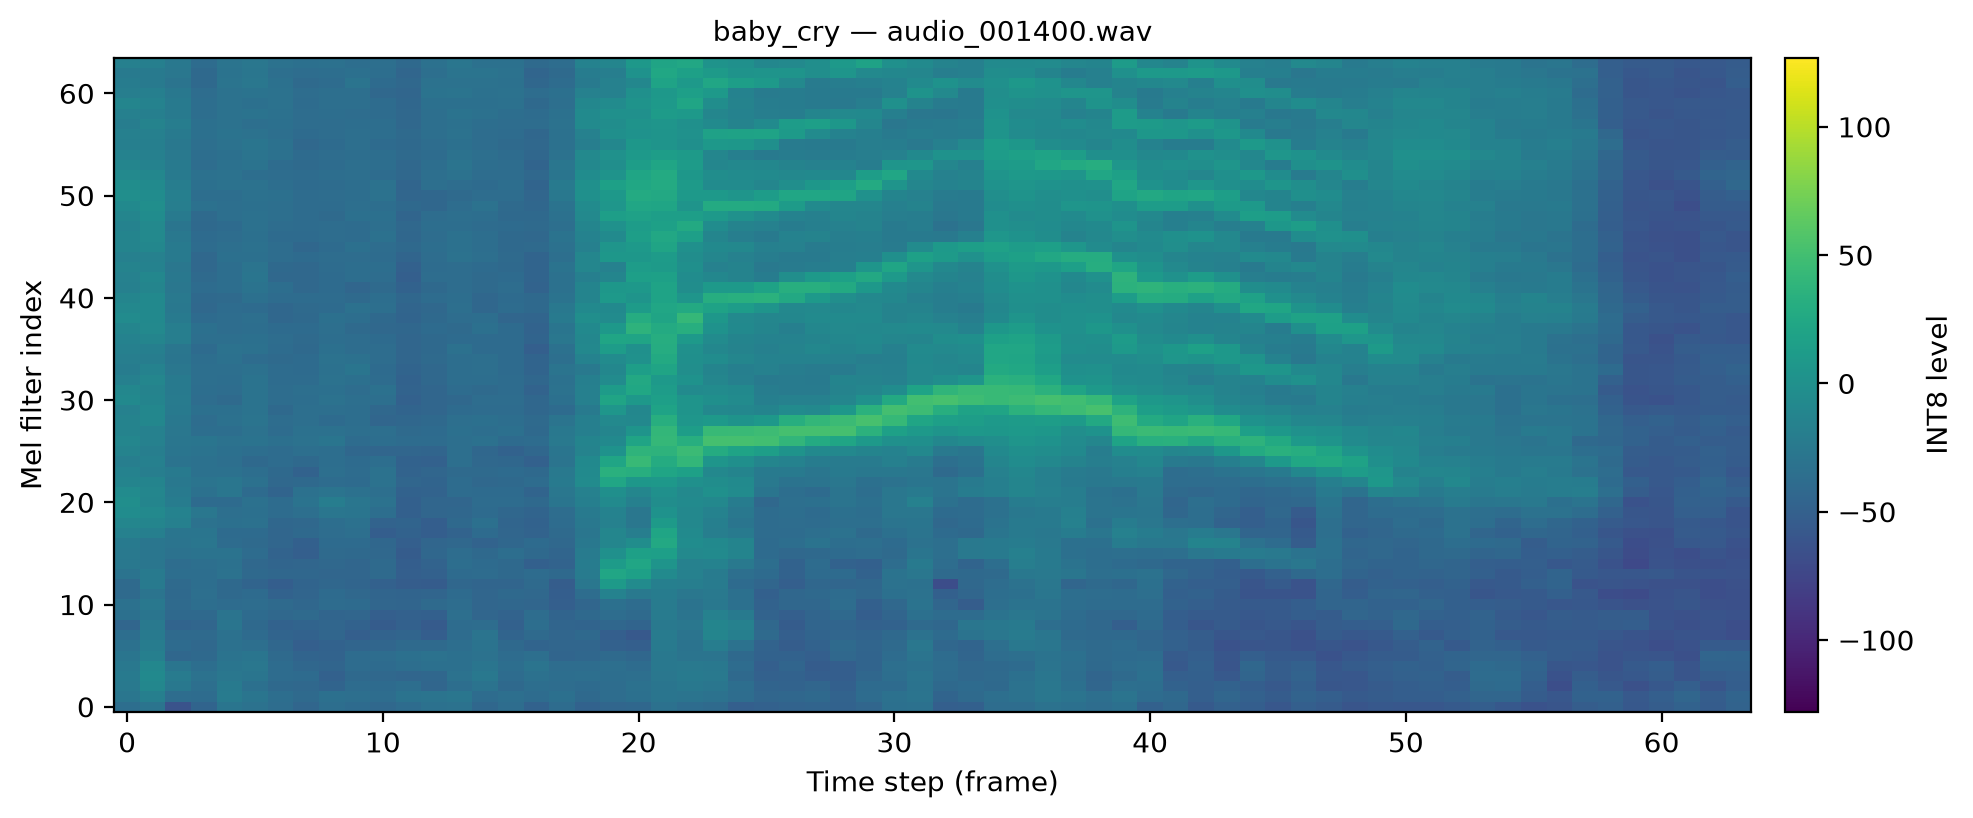
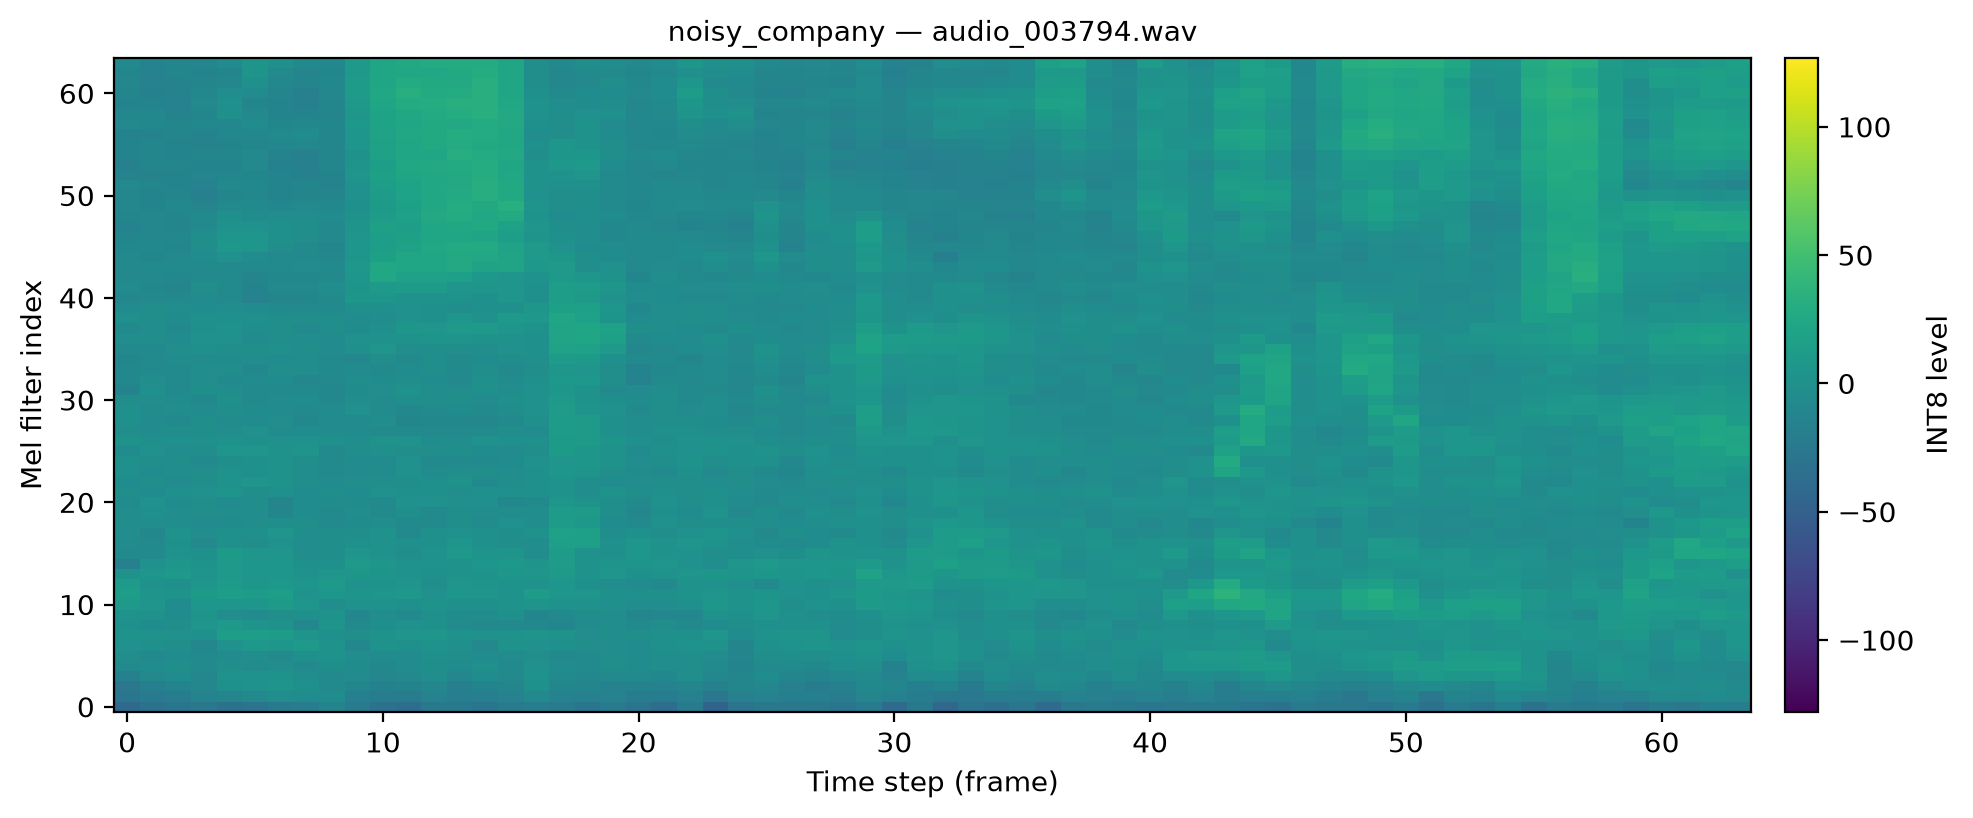
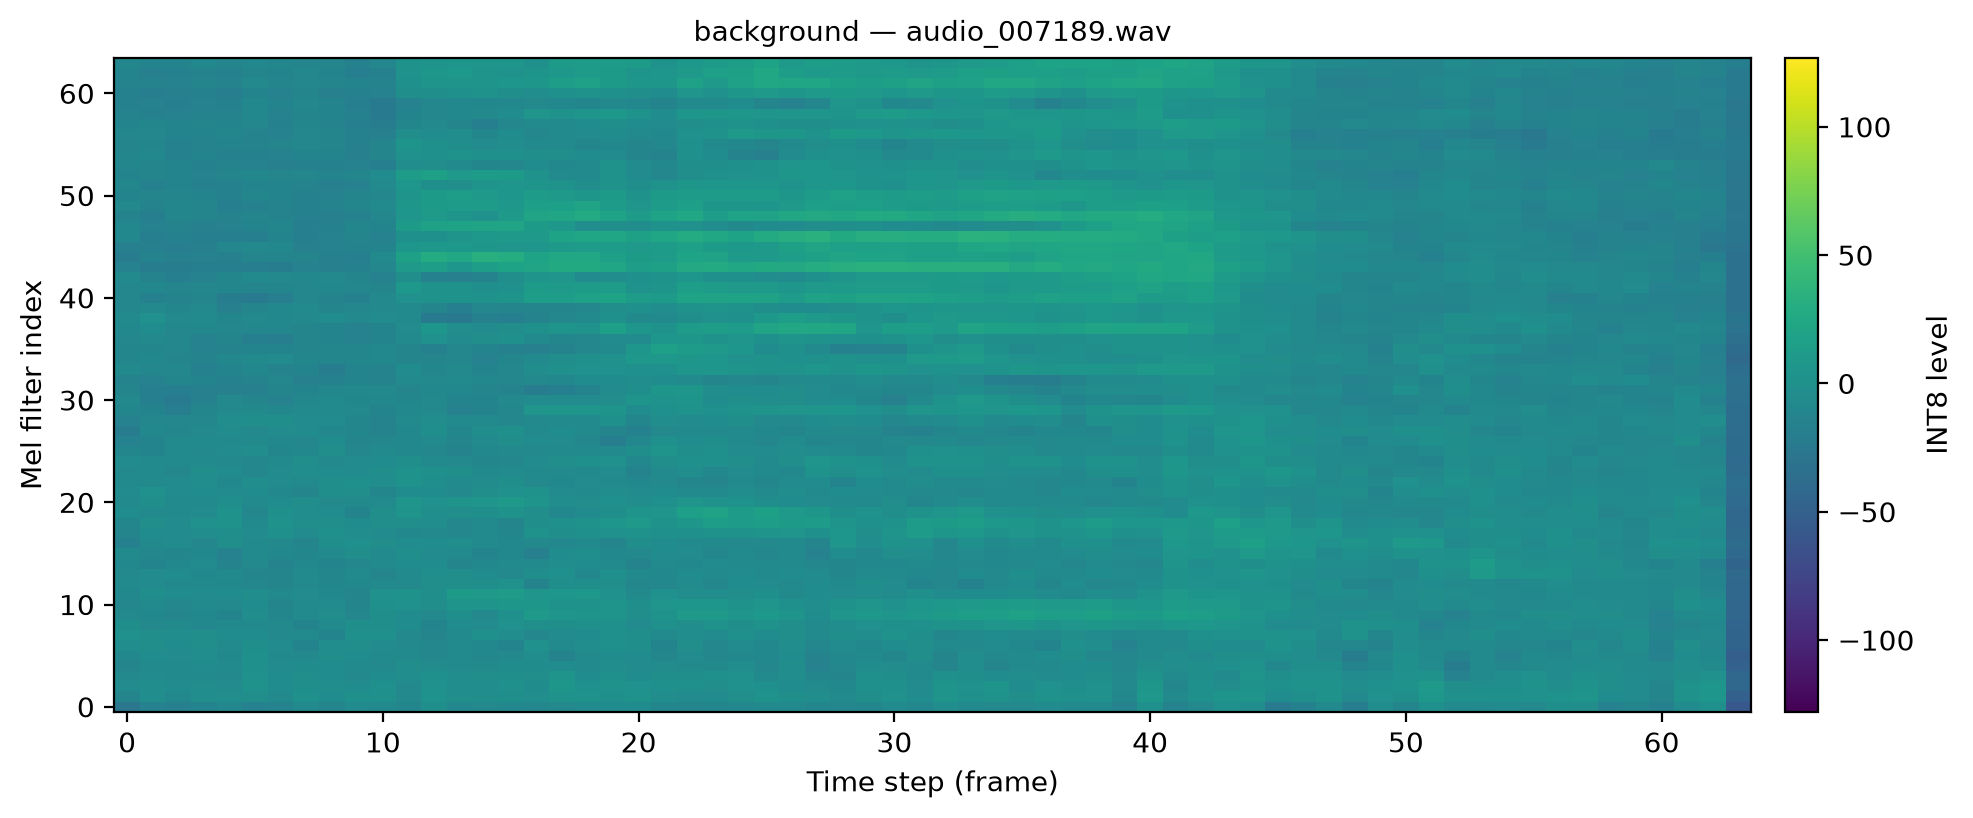
Горизонталь: шаги времени. Вертикаль: индекс мел-фильтра. Цвет: квантованный уровень INT8. Графики можно открыть в исходном размере.
05 / РАБОТА С ОГРАНИЧЕНИЯМИ
Качество устройства зависит от всей цепочки: от микрофона до опубликованного события. Поэтому итерации затрагивали и модель, и прошивку.
Использовали TensorFlow Lite Micro и квантование INT8. Согласовывали размер сети, нагрузку на устройство и качество классификации.
Расширили классификацию служебными классами речи, медиа и сирен. Это позволяет отличать часть фоновых и похожих сигналов от целевых событий.
Дорабатывали нормализацию входа, сглаживание уровня звука, пороги и временное подтверждение. Калибровку измерительного тракта отделили от оценки класса моделью.
Разбирали логи, обратную связь инженеров и поведение сборок на микрофоне INMP441. Проверяли сетевую логику, задачи прошивки и воспроизведение обучения на стороне заказчика.
06 / РЕЗУЛЬТАТ
Разработали ML-модель и прошивку для локального распознавания акустических событий. Проект передан заказчику с исходниками и техническими материалами.
Классификация на ESP32-S3 с учётом ресурсов микроконтроллера.
Отдельная логика подтверждения и передачи событий через MQTT.
Материалы по сборке, тестированию и обучению для команды заказчика.
Качество распознавания зависит от акустики помещения, микрофона и данных обучения. Добавление новых условий и снижение ошибок требуют проверки на соответствующих записях и, при необходимости, дообучения.
КАК МЫ ПРИШЛИ К РЕЗУЛЬТАТУ
Встроенный ML невозможно закончить только обучением сети. Данные, микрофон, прошивка и проверка на стороне заказчика должны сойтись в одну воспроизводимую цепочку.
Разобрали нужные звуковые события, ограничения локального анализа и целевое оборудование. Подготовили основу для модели, которая должна работать внутри устройства.
Прошли от аудиоданных и обучения до квантованной модели и её запуска на микроконтроллере. Отдельно связали классификацию с обработкой сигнала.
Получали логи и замечания инженеров, корректировали пороги, фильтры и служебные классы. Проверяли не только вывод модели, но и то, какое событие в итоге формирует устройство.
У команды заказчика должна быть возможность собрать решение и работать с моделью самостоятельно. Поэтому завершение проекта включало инструкции, материалы обучения и обратную связь по воспроизведению.
ЧТО ОКАЗАЛОСЬ ВАЖНО НА ПРАКТИКЕ
За внешне простым уведомлением скрывается несколько разных инженерных задач. Каждую пришлось проверять отдельно.
При перегрузке входного тракта сигнал искажается. На спектральном представлении появляются дополнительные компоненты, и модель получает уже не тот звук, на котором её обучали. Поэтому работа с входным уровнем и нормализацией была частью решения, а не настройкой «на потом».
Если порог привязан к растущему фону, продолжительный звук способен сам поднять планку срабатывания. В проекте разбирали эту связь и корректировали логику порогов для длительных событий, чтобы измерительная часть не противоречила логике распознавания.
Поправка уровня звукового давления относится к измерениям. Оценка класса относится к модели. Эти величины встречаются в общей логике принятия решения, но нельзя считать, что изменение одной автоматически делает другую точнее. Для диагностики важно видеть оба слоя.
Помимо классификации, устройству нужны сеть, настройки, индикация и обработка команд. В итерациях разбирали последовательность подключения MQTT и Wi-Fi, распределение памяти задач и контроль состояния стеков. Это такая же часть встроенного ML, как сама нейросеть.
ПЕРЕДАЧА ПРОЕКТА
Для технологического продукта важна самостоятельность команды. Передача решения включала материалы, с которыми можно продолжать разработку, проверять сборки и возвращаться к обучению модели.
01 / РАСПОЗНАВАНИЕ
Подготовленное представление сети для интеграции в прошивку и локальной классификации аудио. Размер и формат модели согласованы с ограничениями микроконтроллера.
Часть переданного программного решения
02 / ИСХОДНИКИ
Встроенное ПО связывает модель с микрофоном и логикой устройства. Команда может разбирать не только итоговое событие, но и поведение отдельных этапов.
Для продолжения разработки на стороне заказчика
03 / РАЗВИТИЕ
Передача включала компоненты и инструкции по работе с моделью. Самостоятельное переобучение стало отдельным критерием проверки со стороны команды клиента.
Новые условия требуют проверки на соответствующих данных
04 / ПЕРЕДАЧА ЗНАНИЙ
Пояснения помогают команде собрать проект, настроить измерительный тракт и правильно читать результаты тестирования.
Содержание материалов показано без публикации закрытых исходников
ОБРАТНАЯ СВЯЗЬ
В конце работы фокус сместился с очередного билда на передачу знаний: сможет ли команда самостоятельно воспроизвести и переобучить модель. Это требование определяло, что должно войти в комплект передачи.
Нам сейчас важно удостовериться, что мы сможем переобучать модель самостоятельно.
ЧТО ПОКАЗЫВАЕТ ЭТОТ КЕЙС
Модель должна узнавать нужные звуки, прошивка должна правильно обращаться с сигналом, а команда должна понимать, как проверить и развить результат. В «Индор» мы работали со всей этой цепочкой.
ЕСТЬ ПОХОЖАЯ ЗАДАЧА?
Расскажите, какой сигнал нужно обрабатывать, какое оборудование уже есть и в каких условиях оно будет работать. Если пока нет датасета или точного технического задания, начнём с задачи и доступных материалов.
Определим, что можно выполнять локально, какие данные понадобятся для обучения и как проверять результат на вашей стороне.
ОТ ИДЕИ К РАБОТАЮЩЕМУ РЕШЕНИЮ
Пришлите описание задачи или расскажите, на каком этапе остановились. Поможем определить состав разработки и точку, с которой стоит начать.
Связаться с VIQQДоступность
Уйти с сайта?
Ссылка открывает другой сайт:
ВЗГЛЯД КОМАНДЫ
Комментарий
менеджера проекта
Главное в проверке: различать предположение модели и фактическое срабатывание устройства. На это Артур обращал внимание команды заказчика в ходе тестирования.
Из рабочей переписки по тестированию, 2 октября 2026